Метрики эффективности delivery-процесса: масштабируем управление командами, опираясь на факты
[!disclaimer] Предисловие Эта статья — расшифровка моего доклада «Метрики эффективности delivery-процесса: масштабируем управление командами, опираясь на факты» с Saint Team Lead Conf 2026. Я взял текст, который писал для себя при подготовке доклада, подкорректировал его, сократил и выложил отдельно. Здесь практически нет отличий от доклада, соответственно можно прочитать статью, а можно посмотреть запись.
Для кого эта статья?
Эта статья про то, как взять подразделение разработки и оцифровать его рабочий процесс. Соответственно, она интересна в первую очередь миддл-менеджерам, которые смотрят сверху на свои команды и хотят понимать, что в них происходит. А тимлидам тут может быть интересно то, как на их работу смотрят сверху, — или понять одну из компетенций, которая понадобится им при росте по иерархии.
В то же время это не статья для директоров больших компаний (мне ли вас учить?): рассматриваемый масштаб — это отдел из ~10 продуктовых команд / ~100 разработчиков. В общем для департаментов на 1000 голов эти практики слишком локальны, а для команды из 10 человек — слишком громоздки.
А вот для тех, кто между десятком и тысячью — актуально. Именно на этом, среднем, уровне крутится операционка, и эту самую операционку мы и постараемся улучшить. Текст написан от первого лица, поскольку я сам занимаюсь всем изложенным, и пишу по своему же опыту.
Почему оцифровка важна?
Одна из моих ключевых задач — это оптимизация delivery-процесса. Мне надо, чтобы все команды перформили лучше. При взаимодействии с тимлидами я хочу ставить цели и оценивать результаты не на основе субъективных или эмоциональных факторов.
Я хочу иметь объективные мониторы, которые покажут мне правду, очищенную от оценок пальцем в небо вроде «ну, эта команда пободрее». И заодно хочу получить инструмент для тимлида, который поможет ему трезво оценивать свою команду и свою собственную деятельность.
Зачем мы хотим смотреть на циферки?
Зачем управленцы хотят смотреть на циферки? Есть целая школа мысли про это — Evidence-Based Management. Почему люди к этому пришли?
Во-первых, чтобы управлять на основе фактов, а не домыслов. Цифры не врут. Предположения или обобщения врут осознанно или неосознанно. Оцифровка задаёт чёткую предметную структуру и прозрачное понимание у тимлидов, в каком состоянии их команда находится и какие результаты показывает. Оцифровка даёт объективную картину происходящего, позволяет работать с доказанными тенденциями.
Например, похожую мысль можно транслировать двумя образами:
«Вроде бы полечили проблемы и стали лучше оценивать, так продакт нам сказал!»
или
«Снижение размаха cycle time по всем когортам задач подтверждает улучшение точности оценки и имеет дополнительный сигнал в отзыве продакта».
Во втором случае мысль имеет подтверждение, а в первом — только мироощущение и слова стейкхолдера.
У меня были случаи, когда субъективно кажется, что в команде небольшие проблемы с декомпозицией. А быстрый взгляд на простейшую диаграмму количества задач по оценкам показывает, что треть задач не оценивается вообще. После этого понятным образом проблема коммуницируется тимлиду и выставляется фокус на отладке процесса в команде.
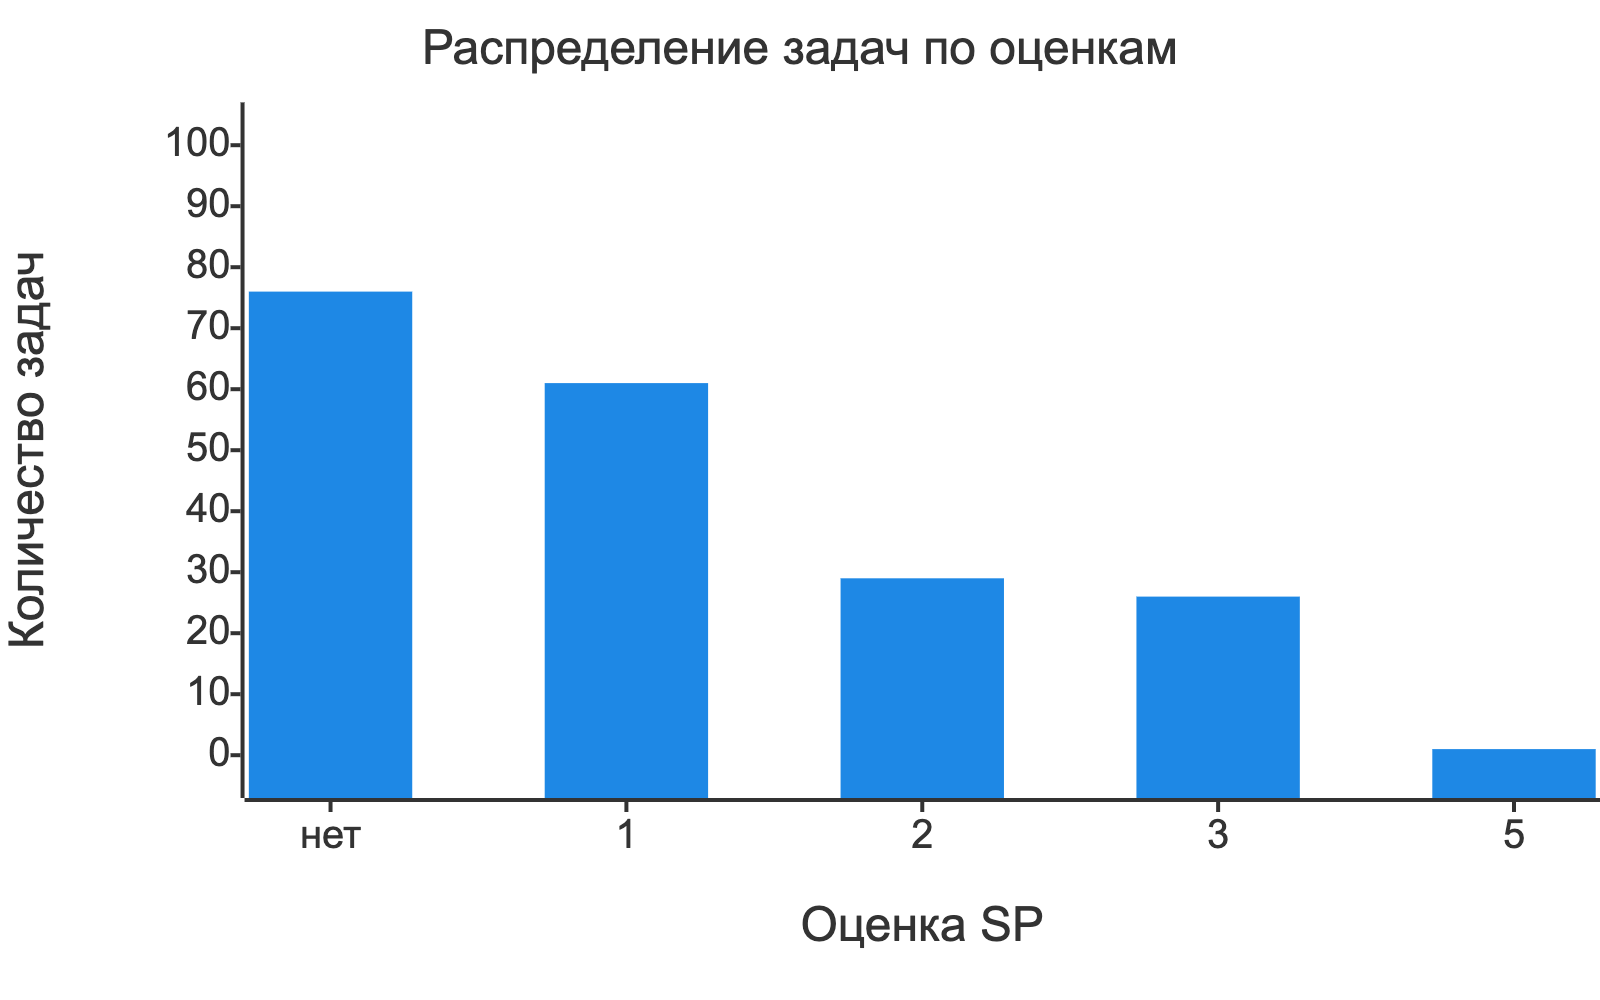
Во-вторых, чтобы иметь бенчмарк. Цифры понятны. Управление на основе оценочных суждений работает с категориями «больше-меньше». Постановка задачи в этих категориях не позволяет провалидировать результат: если цель — сделать «больше», то как понять, +10% — это хорошо или плохо? Но что ещё хуже — без накопленных данных у вас нет бенчмарка. То есть, ставя задачу, вы сами не знаете, а какой в ней потенциал, и какой результат будет хорошим: надо что-то вспоминать, угадывать, прикидывать «на глаз».
Например: если цель — сделать «меньше» шумных алертов, то как понять, −10% — это хорошо или плохо? Если есть бенчмарк, то есть референсные показатели, вы имеете совершенно другой уровень понимания при постановке задач:
«В этой команде много алертов летит»
против
«В этой команде алертов в 4 раза больше референсных показателей для команд схожего размера и схожей зоны ответственности».
Даже такие вещи, как срабатывания алертов, хорошо выражаются в статистическом виде, и по ним тоже вполне можно сравнивать команды друг с другом, находя аномалии.
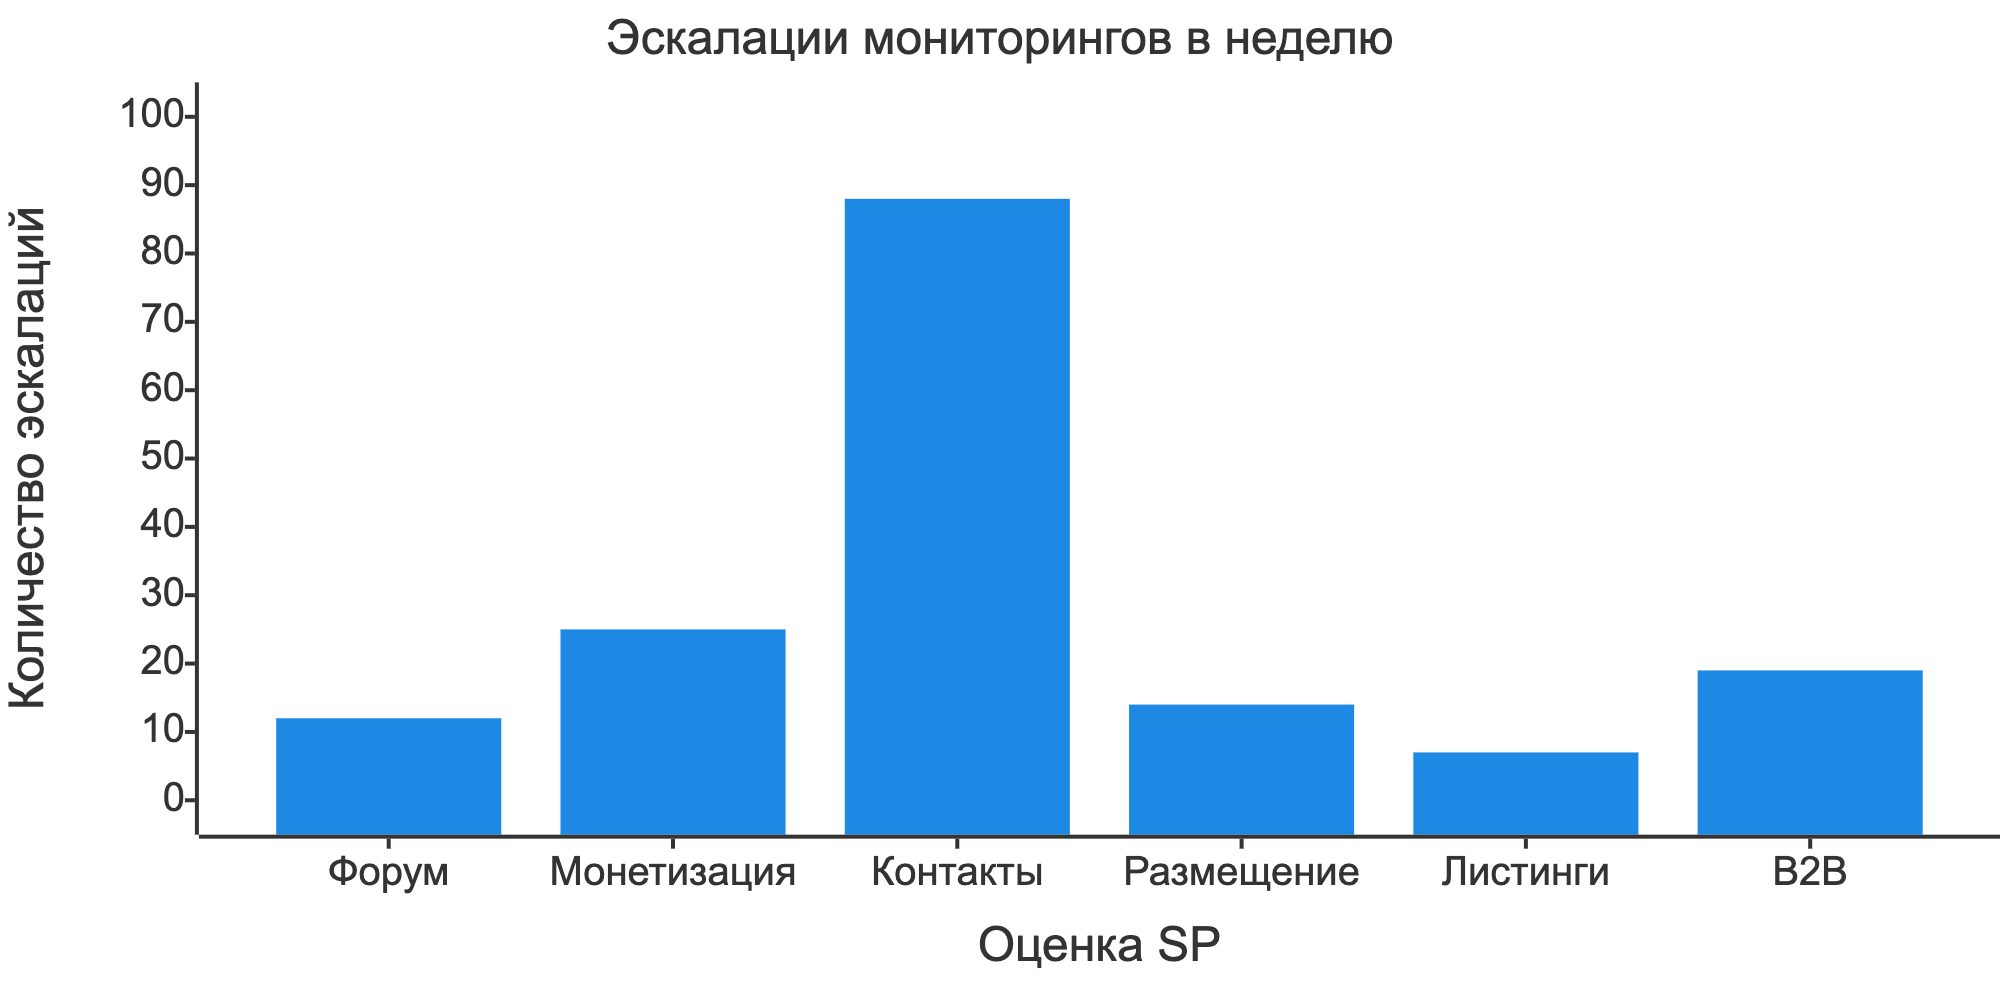
Кстати, тут есть ещё интересный момент. Иногда управленческие метрики ассоциируются с задачей вычислить и наказать тех, кто плохо работает. Но я регулярно использую их для того, чтобы справедливо вознаградить тех, кто достиг выдающихся результатов. От бенчмарка можно отклоняться и в большую сторону, и факты на столе отлично подтверждают результат выдающейся работы. Например: команду перестроили с нуля, начали налаживать процессы — и на дашбордах видно, как команда за кратчайшие сроки вошла в референсные диапазоны. Это пруф достижений нового тимлида.
Почему хочется смотреть на циферки в разрезе команд
Теперь о том, почему хочется смотреть на метрики именно в разрезе команд, а не целиком по подразделению или отдельно по людям.
Масштабирование. Когда руководишь 1–3 командами, их состояние и динамику можно держать в голове. Приходишь на мероприятия и наблюдаешь движение тикетов по доске. Или, например, обращения в дежурство: просто пересчитал их и всё.
Но если команд 10? Тогда нужно строить представление управляемой системы в виде различных приборов над командами, абстрагируясь от их внутрянки и получая по ним статистики. То есть я хочу не погружаться в отдельно взятую команду, а окинуть взглядом дашборды и получить сравнительное представление о динамике обращений в дежурства у них.
Описание деятельности команд. Представление системы, её схема, описывает не только свой объект, но и деятельность, в которой эта схема используется. Например, хотим заняться организацией связей между командами — и рисуем схему из Team Topologies. А хотим отслеживать пропускную способность тех же самых команд по выполнению задач — берём диаграммки из канбана.
Соответственно, настраивая метрики, мы определяем различные разрезы, в которых будем оценивать нашу систему. А если шире — мы определяем деятельности, которые нам интересны настолько, что мы за ними следим и даже управляем.
Фреймворк для тимлида
А раз этими статистиками в разрезе команд мы описываем деятельность, то мы… строим фреймворк для тимлида! То есть буквально определяем, на что смотреть, какая деятельность требует внимания.
Дашборд команды. Знакомая всем картинка — дашборд микросервиса, на котором выводятся его основные метрики. Открываем его — и сразу видно, на что смотреть, по каким показателям искать аномалии.
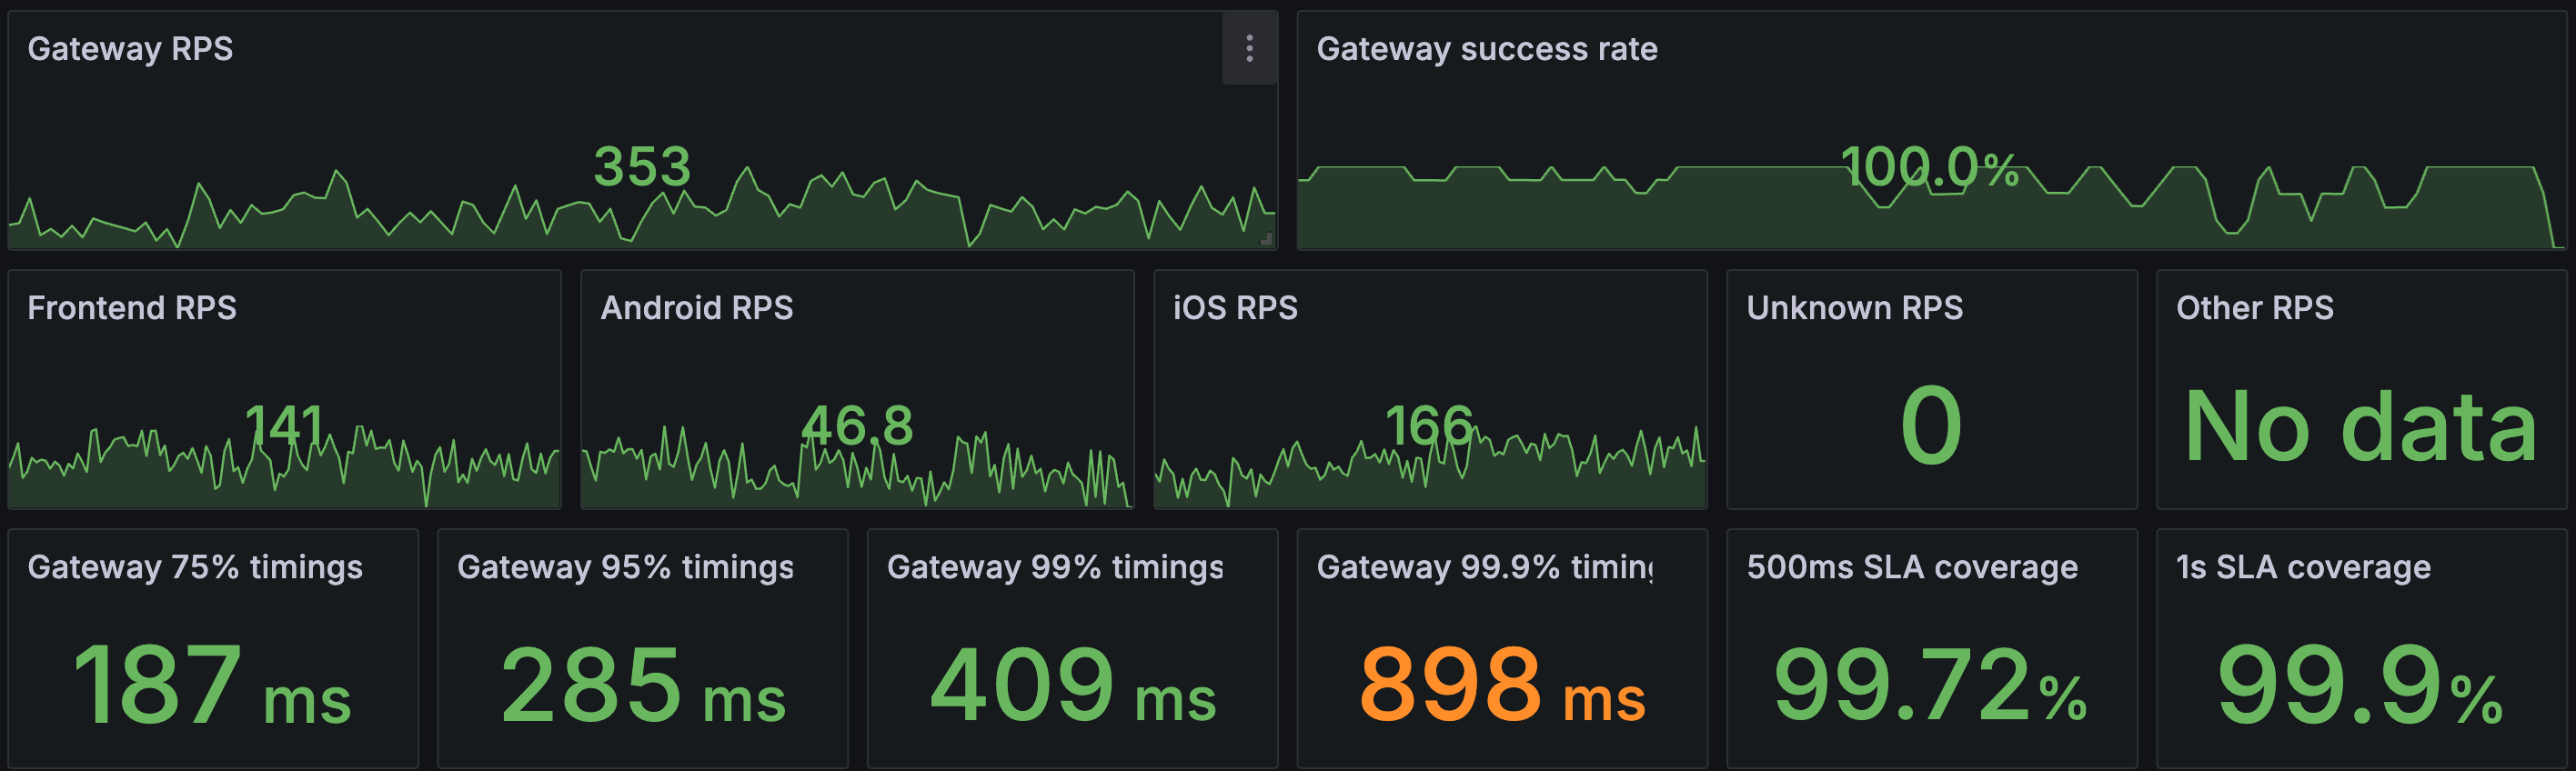
А теперь представим, что и по команде можно такой сделать.
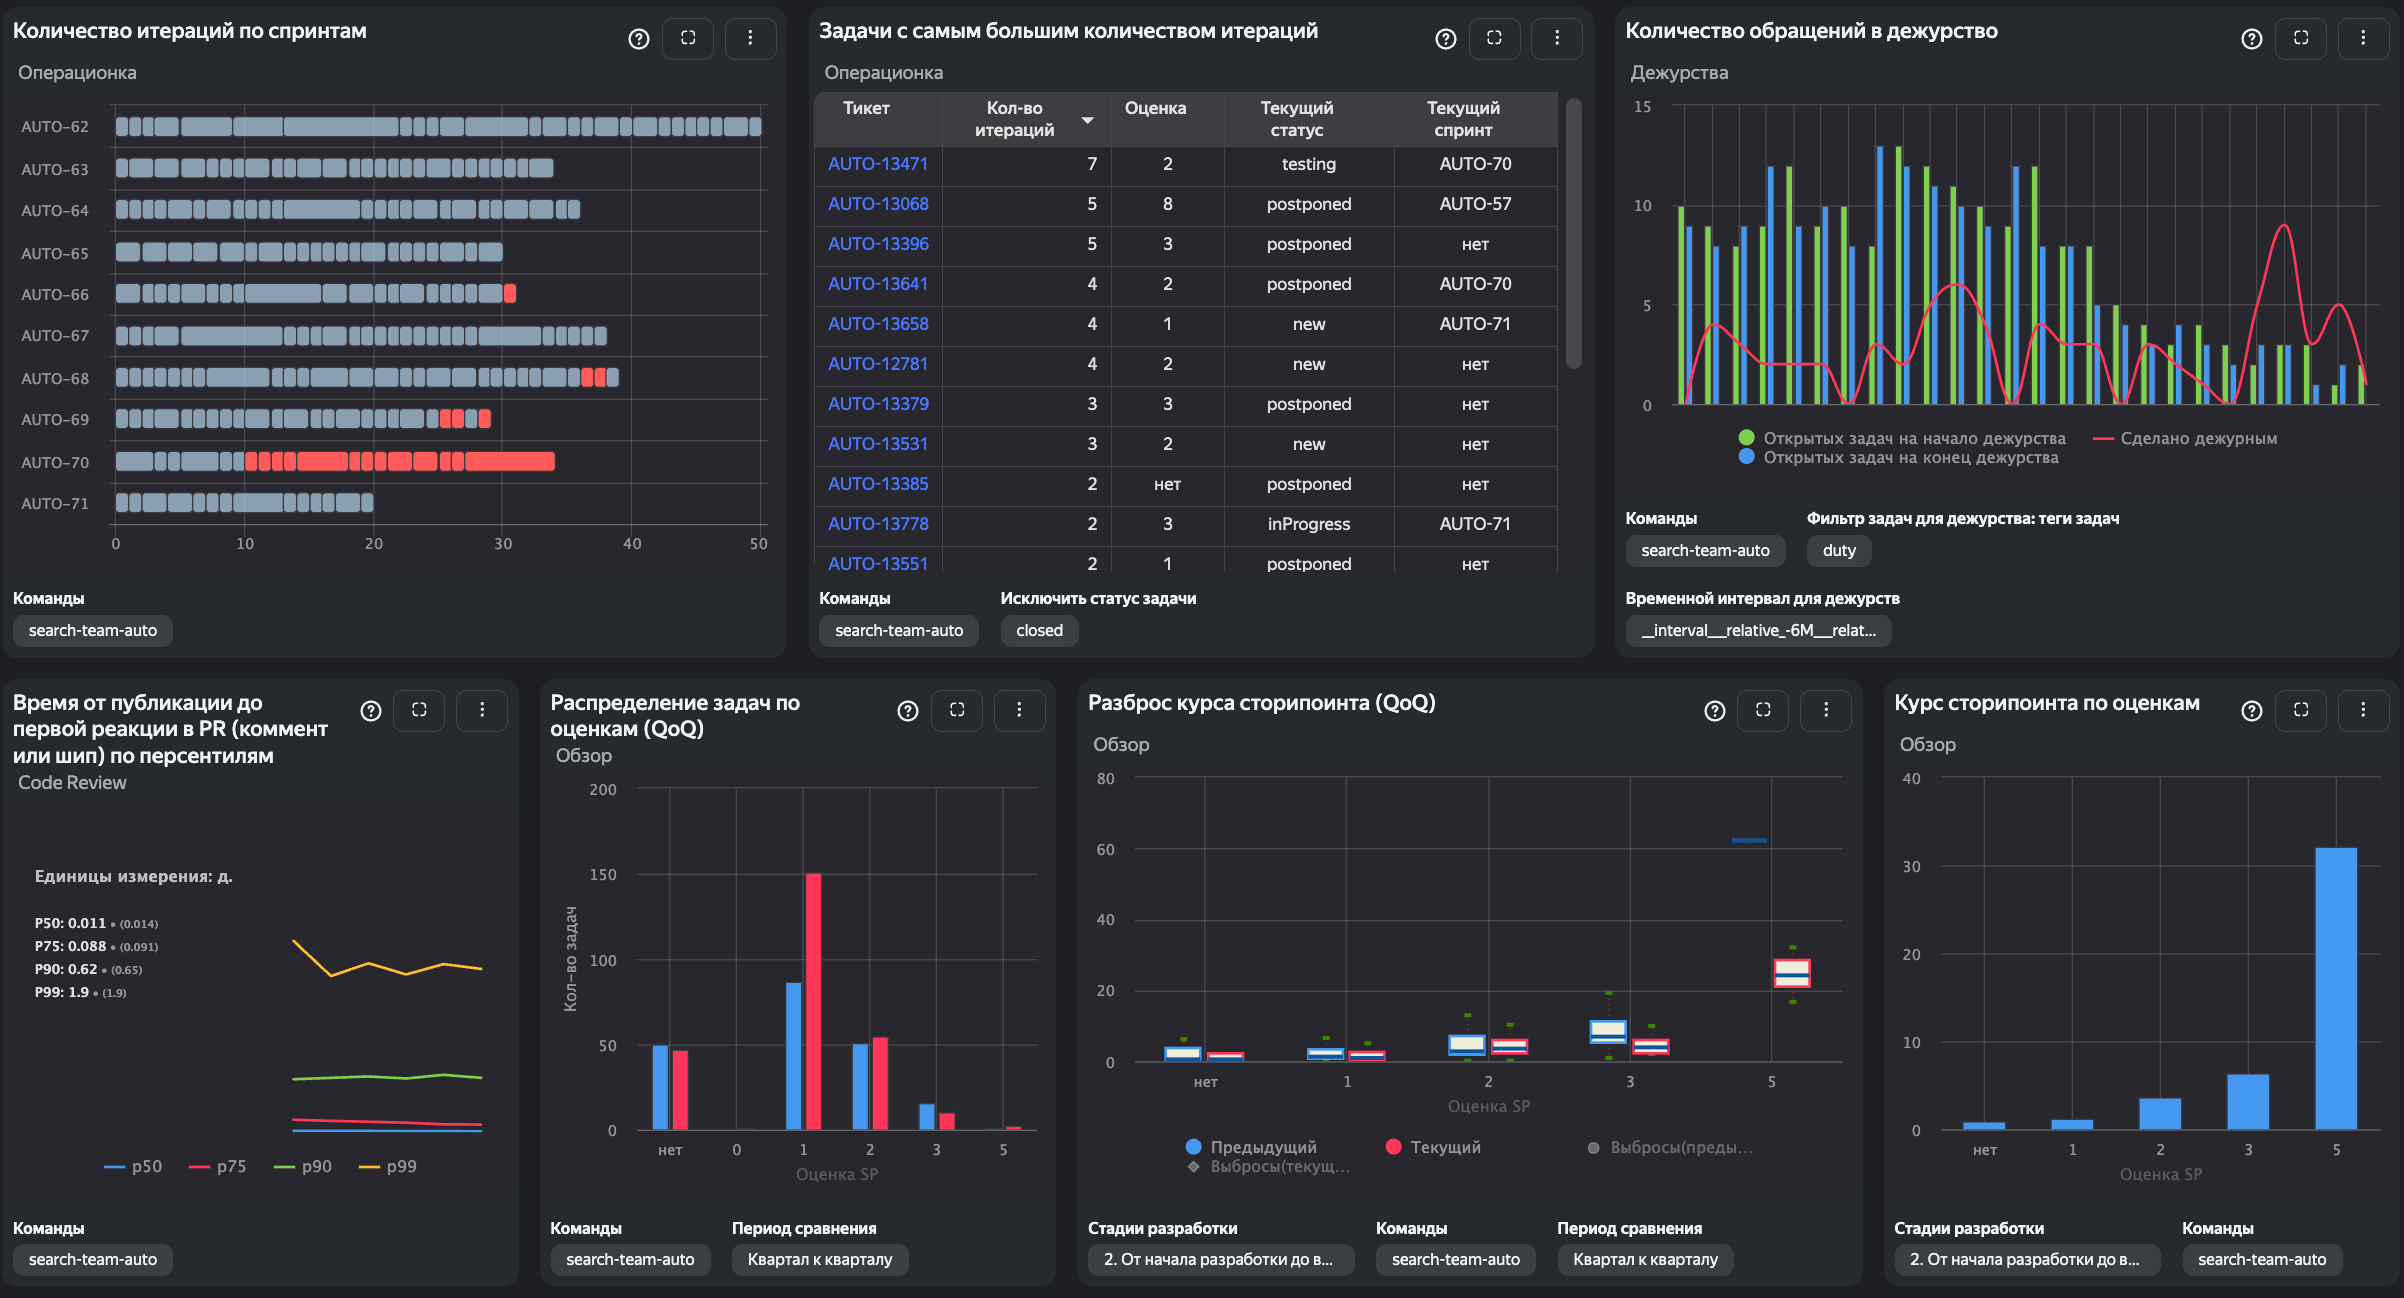
У тимлида появляется «дашборд», на котором отображаются показатели его команды по аналогии с мониторингами сервисов для разработчиков. Соответственно, перед тимлидом появляется предметная структура, на которую он может воздействовать и наблюдать результат.
Возможно, кто-то из вас впервые становился руководителем в чистом поле: должность вам дали, а инструментов не завезли. Как хочешь, так и руководи, сам нащупывай интересующие тебя структуры. А тут у нас сразу есть фреймворк: вот тебе деливери-метрики (ага, значит нужна точность оценки), а вот тебе метрики даунтайма (ага, нужна надёжность). И так далее.
Целевые и отладочные метрики.
[!quote] Вспомним закон Гудхарта Статистическая закономерность склонна к разрушению, как только на неё оказывается давление с целью управления.
В некотором роде мы позитивно используем закон Гудхарта: не давим на метрики, а формируем ими точки интереса.
Раз затронут закон Гудхарта, немного о давлении. Важно разделять метрики на целевые и отладочные. Большинство метрик отладочные: они подходят только для диагностики аномалий и выявления отклонений от бенчмарка либо от показаний в прошлом. Лишь малое количество очень-очень осторожно можно закладывать людям в цели.
Раз я говорил про дашборды команд, хорошая аналогия будет с дашбордами микросервиса. Никто же не ставит сотрудникам цель «уменьши метрику RPS своего сервиса на 10%». Цель вокруг диагностической метрики может звучать как «изучи, почему RPS в твой сервис превышает RPS апстрима на 10%, не является ли это следствием несовершенства системы».
С метриками рабочего процесса так же: просто ни-ког-да не ставьте цели вида «повысить метрику количества сжигаемых за спринт сторипоинтов». Круто сравнивать с референсными значениями, искать аномалии и узнавать причины. Не круто ставить цели по отладочным метрикам.
❌ «Снизить средний cycle time для задач с оценкой 3 SP»
✅ «Средний cycle time для задач с оценкой 3 SP в несколько раз выше, чем у других команд, давай проведём анализ процесса декомпозиции, достаточно ли она гранулярна»
А вот более сложные по своей сути метрики, близкие к бизнес-целям и находящиеся во власти человека, можно очень-очень осторожно ставить в цель. Например, метрика даунтайма сервиса. Почему осторожно? Потому что даунтайм может вырасти из-за аварии в инфраструктуре, и подобные внешние влияния могут дискредитировать само целеполагание.
В цели мы ставим:
- метрики в терминах бизнес-результатов, если это возможно (!) — например, Service Downtime, Delivery Rate по продуктовым проектам;
- диффы по отладочным метрикам с доказанным влиянием на бизнес-цели.
В общем-то ставим цели по SMART, это понятная история. С метриками разработки хочу только подсветить, что в цели они могут прорастать в двух случаях: если нам повезло и мы можем этому конкретному сотруднику поставить в цель бизнес-метрику (например, он имеет прямой импакт на даунтайм сервиса); либо изменение отладочных метрик там, где в результате анализа было доказано, что именно эта отладочная метрика является причиной проблемы.
Для постановки цели через метрику должна быть цепочка причинно-следственных связей. Например:
- Доля инцидентов, обнаруженных не по собственным алертам, ниже среднего показателя по компании.
- В этой доле инцидентов более высокий MTTR, что влияет на Service Downtime.
- Надо увеличить долю инцидентов, обнаруженных собственными мониторингами, до средних показателей.
Анализ причин и следствий. Наличие такого фреймворка очень хорошо помогает тимлидам различать ситуации, когда они всё сделали правильно, но по некоторым вероятностным факторам не получили желаемый результат, от ситуаций, когда хороший результат получен случайно.
| Действие / Результат | Хороший | Плохой |
|---|---|---|
| Правильное | ✅ | ✅ Неудача по проекту, но на delivery-метриках не видно системных проблем |
| Ошибочное | ❌ Запустили проекты, но по метрикам просели процессы | ❌ |
Например: запустила команда два сложных проекта за период, а деливери-метрики показывают практически полное отсутствие процессов. Сразу понимаем, что проекты запущены в надрыв, и повторяемости ждать не стоит. Поэтому поощрять такое поведение надо очень осторожно. Или наоборот: продакт жалуется на неудачу по проекту, а команда по всем метрикам работает стабильно и прогнозируемо. Оставляем их ненадолго в покое и получаем снова крутые результаты в проде. Чем больше у тебя данных, тем легче принимать такие решения.
Проблематизация: метрик много, выбрать сложно
Итак, мы разобрались, что метрики — это полезно. А ещё поняли, что наш объект наблюдения — это команда, и метрики помогут создать фреймворк для тимлида. А что с ними делать, как внедрить?
За последние лет пять появилось сразу несколько фреймворков измерения продуктивности разработки: DORA, SPACE, DX Core 4. А ещё есть SRE-метрики, кадровые метрики… В старом добром канбане метрик десятки. Что из этого взять и внедрить? Всё сразу и внедрить не получится, и использовать невозможно. А что выбрать? И, сталкиваясь с таким многообразием вариантов, можно пойти по одному из ложных путей:
- А что, если не мерить вообще? Не жили богато, неча и начинать. Будем руководить как-то без систем оцифровки. Но почему оцифровка важна, написано в первом разделе, так что постараемся всё же получить перечисленные выгоды;
- А что, если взять и внедрить популярное? Сейчас есть инструменты с десятками заготовленных метрик разработки. Покупаешь софт, внедряешь… Вот только как это всё грамотно внедрить, а потом ещё и смотреть — непонятно. Внедрить и заб(ы/и)ть. А ещё хуже — получить поломанный инструмент принятия решений.
Вот внедрил ты Deployment Frequency из DORA, смотришь на график по всей организации: деплои деплоятся, красота! А проекты с ценностью для пользователя почему-то не сходятся. И что делать?
Получается, что надо не просто что-то внедрить, а внедрить с умом.
Как собрать метрики под себя?
У вас свои цели… и неплохо бы их понять
Метрики имеют смысл только вместе с правильными целями, поставленными в соответствии со стратегией бизнеса. Плохо, если для бизнеса первым приоритетом является надёжность системы, а вы будете вместо контроля инцидентов медитировать на Cumulative Flow Diagram из канбана.
Backcasting. Но далеко не везде есть явно прописанная стратегия компании, в частности, разработки, поэтому цели придётся находить самостоятельно. В этом поможет обратная индукция, а конкретнее — backcasting: восстановление цепочки действий из текущего состояния в желаемый результат, делая шаги «обратно» от результата.
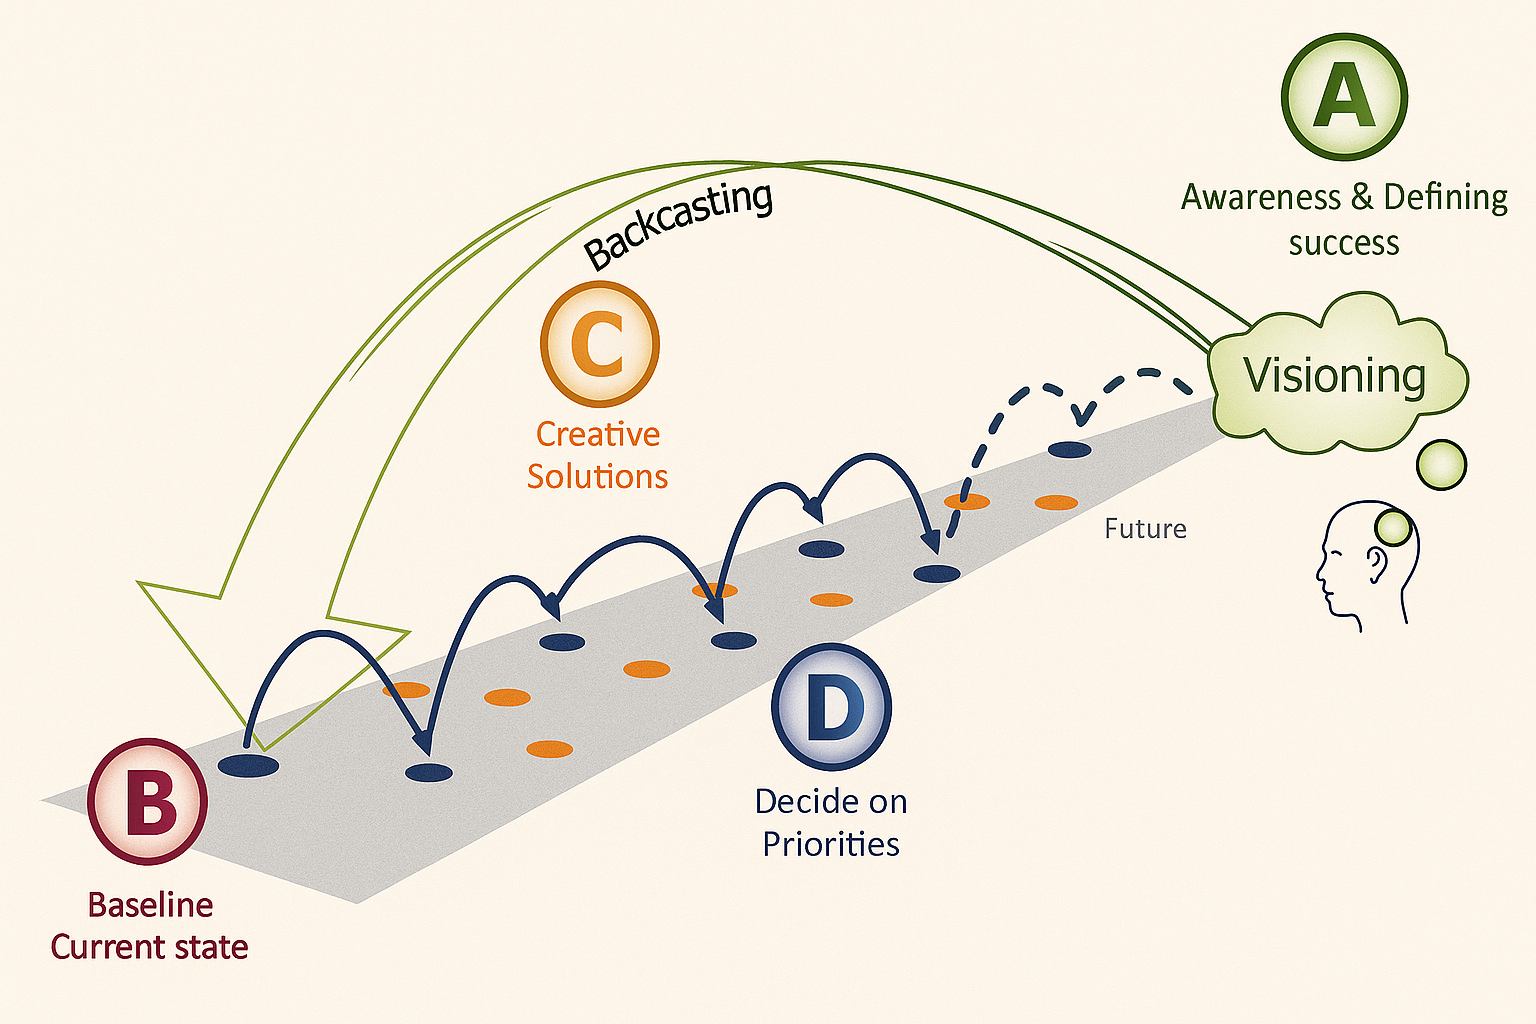
У вашей компании точно есть целевые бизнес-метрики: выручка, аудитория, оборот. Если вы их не знаете, их надо узнать. Берём их за стартовую точку и делаем шаг назад. Каким образом разработка вносит вклад в эти метрики? Нащупываем главные результаты от разработки. Измеримые показатели по этим результатам — это ваши попытки построить целевые метрики. Делаем ещё шаг назад: что влияет на эти целевые метрики? Находим гипотезы и уезжаем по нашей шкале «усилия — результат» до самого начала усилий :)
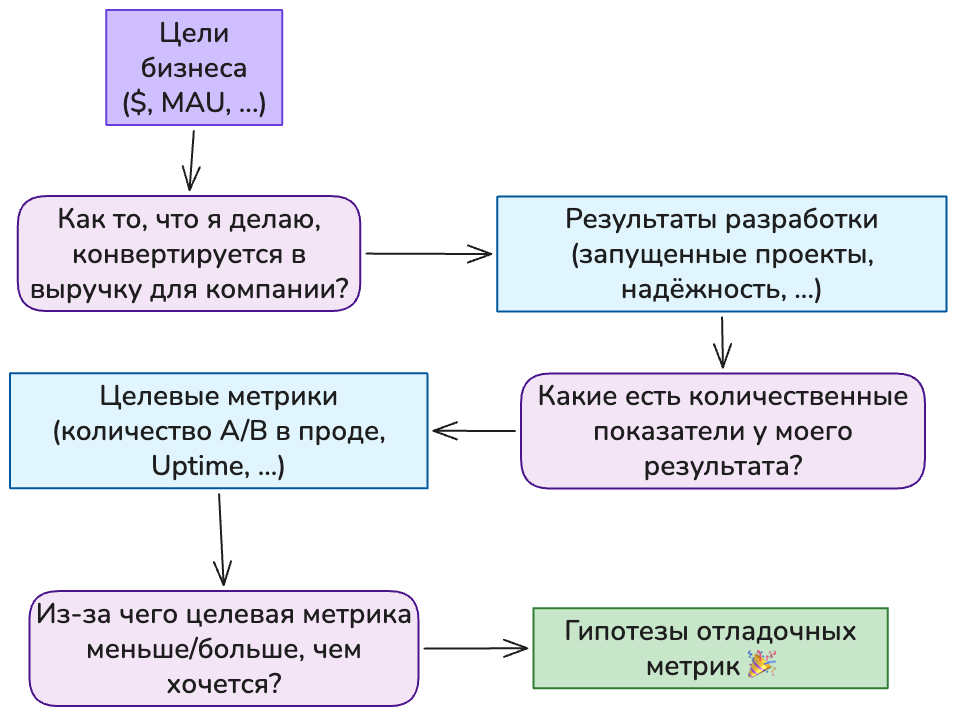
Копайте глубже. А потом повторяем всё это много раз в цикле общения со стейкхолдерами! Общаясь с ними, задавайте много вопросов «почему?», закапывайтесь в суть.
Стейкхолдер может утверждать, что он хочет оптимизировать time-to-market, но за этим может скрываться желание получить прогнозируемость или прозрачность. Может выясниться, что оптимизировать надо TTM лишь маленькой когорты проектов! Если вы это не выясните и побежите раскатывать канбан на всю компанию, это будет большая ошибка.
[!tip] Чтобы найти правильные целевые метрики, … … выявляйте показатели, по которым стейкхолдеры поймут, что они довольны.
Три категории метрик. Помимо бизнес-метрик есть ещё и здоровье вашего отдела разработки на дистанции, которое подразумевает кадровые метрики: отток сотрудников, распределение грейдов, NPS разработчиков, span of control. В целом метрики можно поделить на три категории:
- Delivery (как вы поставляете ценность);
- Надёжность (насколько мало у вас аварий);
- Здоровье (насколько ваша организация устойчива).
И выбирать те из них, которые наиболее важны в текущий момент.
Виды метрик
Теперь определимся, какие виды метрик бывают во всех этих категориях. Я пользуюсь классификацией в нескольких разрезах: место в цепочке поставки ценности, сложность внедрения, универсальность.
Место в цепочке поставки ценности. Цепочка поставки ценности — это путь от прилагаемых усилий сотрудников до результатов для бизнеса. Прилагаемые усилия — это то, что разработчики делают каждый день: пишут код, проводят код-ревью. А результаты для бизнеса — это влияние созданного продукта на финансовые показатели компании и бизнес-метрики, которые взяты в качестве цели (например, аудитория продукта). Между усилиями и бизнес-результатами стоит множество промежуточных результатов: от дизайн-документов и деплоев в продакшен до запущенных A/B-экспериментов. Каждый промежуточный результат имеет смысл не сам по себе, а в той мере, в которой он влияет на бизнес — например, приносит деньги или аудиторию.
Можно представить шкалу, на которой слева будут низкоуровневые усилия, а справа — бизнес-результаты, и расположить по ней этапы цикла разработки. У каждого этапа будет показатель, который можно так или иначе замерить: например, lead time проектов, количество запущенных A/B за период или количество деплоев сервиса в продакшен. Смотрим на эту шкалу и видим, что оценить вклад именно отдела разработки в итоговую выручку сложно (на неё влияют и маркетинг, и продажи), но вполне можно подобрать промежуточный результат, наиболее близкий к ней и находящийся в ведении разработки.
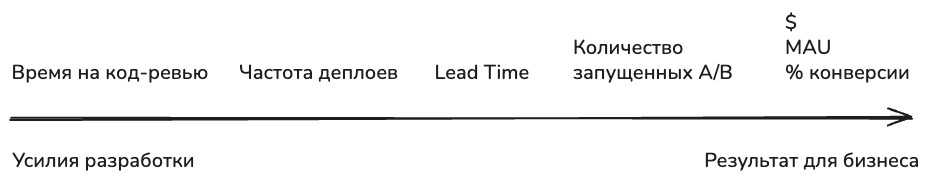
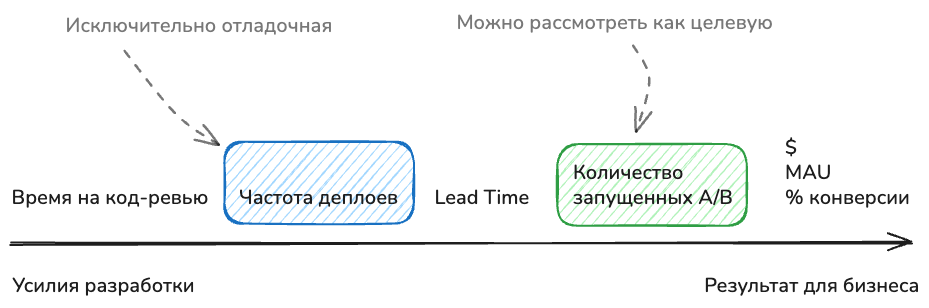
И тут мы вспоминаем про целевые и отладочные метрики! Каждая метрика, которую мы можем придумать, где-то расположена на этой шкале. И чем ближе она к бизнес-результату, тем больше мы можем использовать её в качестве целевой. А если метрика ближе к усилиям — только как отладочную. Отладочные метрики самоцелью не являются, они нужны, чтобы выявлять референсные диапазоны и искать аномалии.
Например, доля проектов, запущенных с A/B в рамках квартального плана, может быть осторожно поставлена в цель. А вот метрика «частота деплоев» может быть использована только для «дебага» команд в сравнении друг с другом.
Сложность внедрения. Это очень простая характеристика метрики: насколько вам сложно внедрить метрику в свои рабочие процессы? У вас может не быть единообразной работы с продуктовыми эпиками в разных командах — тогда сбор части канбан-метрик затруднится. Или метрику lead time of changes (время от коммита до прода) честно померять сложно из-за особенностей интеграции между системами контроля версий, CD, деплоя.
Что тут есть интересного? Обманчиво простые метрики. Например, lead time. Про lead time часто можно услышать в первую очередь, когда речь заходит о замерах продуктивности разработки. Но в такие моменты всегда интересно, о каком lead time речь и как его собирать?
- Как собирать его на масштабе 10+ команд?
- Какой именно lead time имеет значение в данный момент? Individual lead time, team lead time, system lead time, customer lead time?
- А почему, вообще, нам полезно мерять lead time?
Раскатить сбор lead time на масштабе в 10+ команд — нетривиальная задача. Небольшие отличия во флоу работы с тикетами могут запороть статистику, а внедрение общего флоу будет достаточно дорогим. О каком lead time речь? А как на него предлагается смотреть: средний, в перцентилях, в распределении? На проекты в каких когортах? Почему мы решили, что именно этот тип lead time важен нашей компании прямо сейчас? Ну и наконец, а почему именно lead time нам важно анализировать, почему не cycle time?
Чтобы правильно настроить анализ lead time, надо разбираться в Kanban Maturity Model. То есть внедрение этой метрики дорогостоящее — оно требует теоретическую проработку плюс раскатку на масштабе.
Метрика может казаться понятной, но иметь под собой скрытую сложность. В таком случае надо либо заморачиваться с подбором варианта метрики под свои нужды всерьёз, либо довольствоваться более простой метрикой.
Например, есть сложная метрика даунтайма. Чтобы правильно считать метрику Service Downtime, надо иметь дерево функциональностей сервиса с развесовкой значимости и разметку инцидентов по этим функциональностям. Это отличная метрика, но чтобы к ней прийти, нужно время и высокая зрелость процесса инцидент-менеджмента.
Более простая метрика — это обычно менее точное прокси, дающее некоторое приближение искомой метрики. Например, просто количество инцидентов за период. Она гораздо хуже учитывает критичность, но всё равно даёт некоторое представление о надёжности. Можно спокойно использовать её, пока строится более точная и сложная метрика.
Вывод: выбирайте сложность метрики согласно зрелости замеряемых процессов и не стесняйтесь простых прокси-метрик на первых этапах.
Универсальность. Наконец, метрика может быть более или менее универсальной. Чем метрика универсальнее, тем в большем количестве организаций она применима как есть. А наименее универсальны те метрики, которые вы делаете сами под условия непосредственно своей системы и свои нужды.
Например, метрика частоты деплоя (Deployment Frequency) — это популярнейшая метрика для приближения пропускной способности организации. Зачастую её рекомендуется использовать по дефолту как универсальную пилюлю. Но я считаю, что брать универсальную метрику просто потому, что она популярна, может быть плохо:
- она может быть нерелевантна вашим целям. Например, ваш основной фокус сейчас — это надёжность. Колебания метрики частоты деплоев не будут давать понимание, как вы идёте к своей цели;
- она может соответствовать цели на повышение объёма деливери, но слабо коррелировать с результатами: разработчики деплоят много и в рамках бенчмарка по индустрии, но имеют слабые стороны в процессах оценки или проектирования, из-за чего запусков для пользователей-то и нет;
- наконец, она может быть сдвинута слишком влево по цепочке поставки ценности. Вы и целевых метрик не знаете, а начинаете смотреть на отладочную и пытаться сделать какие-то выводы. А как будете проверять корректность этих выводов? Всегда начинать надо с целей.
В общем, бездумное использование универсальных метрик даёт только иллюзию контроля, а не контроль.
А если наоборот? Есть конкретная гипотеза и понятная цель, но нет метрики. Например, вы хотите обработать конкретную гипотезу о том, что разработчики тратят время в цикле деплоя не на что-то, а на флапающие тесты. Вы можете услышать про это коридорно и сформировать такую гипотезу. При этом её проработка соответствует вашей цели по известной целевой метрике time-to-market.
Тогда вы просто делаете метрику конкретно под расчёт топа флапающих тестов и проверяете корреляцию с более универсальной целевой метрикой. Если корреляция выявлена, то интегрируете кастомную метрику в свой фреймворк.
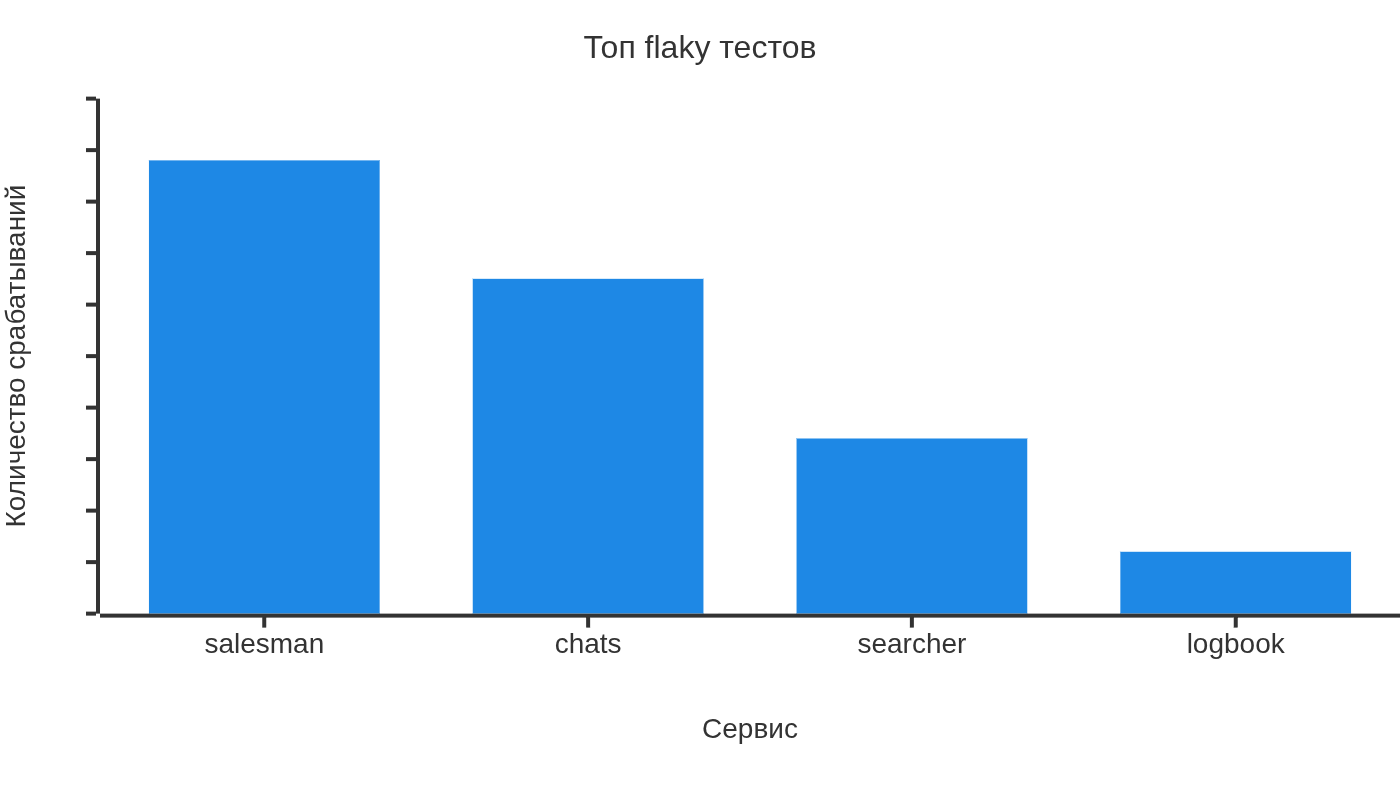
Не стесняйтесь придумывать метрики! Если у вас есть гипотеза, которую вы хотите проработать, не ограничивайтесь популярными решениями. Лучше внедрить кастомные метрики под свои гипотезы, чем набор стандартов из литературы. Потому что более универсальные метрики могут не быть полезны именно для ваших проблем.
Собираем конструктор
Собираем всё воедино. Для примера возьмём следующий контекст:
- компания делает B2C-продукт — какое-то приложение для пользователей;
- разработка состоит из продуктовых команд;
- топы хотят делать фичи «побыстрее».
Ситуация понятная, но для формирования целевой метрики разработки надо собрать дополнительную информацию. В качестве отправной точки возьмём цели компании, то есть те KPI, на которые коммитятся топы. Допустим, у нашей компании это будет выручка и количество активных пользователей (MAU). Теперь наша задача — от этих целей компании провести причинно-следственные связи до импакта разработки.
Формулируем целевую метрику. Попробуем понять, от чего растут метрики нашей воображаемой компании:
- От чего растут бизнес-метрики? — Допустим, на этот вопрос мы получаем ответ: от маркетинга и органики после релизов новых фич.
- Все фичи растят бизнес-метрики? — Нет, только удачные, их ~20%.
- Можно ли сделать заведомо удачную фичу? Может быть, мы тогда будем расставлять приоритеты и прикладывать максимум усилий к этим 20%? Тогда по ним будет лучший тайм-ту-маркет. — Нет! Удачная фича или нет, мы узнаём только по результатам A/B.
- Можно ли повысить долю удачных? Может, это продакты плохо работают, и надо чинить процессы у них, а разработка пока почиллит? — Нет, есть уверенность CPO, что продакты дискаверят достаточно качественно, и лучшую долю удачных фич для нашего рынка сделать не получится.
- А мы все гипотезы успеваем проверять? — Нет! Далеко не все гипотезы падают в бэклог.
Так, покрутившись в while-лупе «почемучек», мы поняли: у нас есть гипотезы от продактов, часть из которых удачные, а часть нет. Предугадать нельзя, только проверить на A/B. Разработка успевает делать некоторую долю от этих гипотез. Раз мы не можем предугадывать, то наш способ импакта на бизнес-метрики — это рост количества фич за период в проде.
- Продакты генерируют N фич в сезон.
- Разработка делает M < N фич.
- S = 0.2 × M — удачные на A/B-экспериментах.
- На бизнес-метрики влияет S, хотим целиться в его рост.
Соответственно, наша целевая метрика — количество запущенных A/B-экспериментов за период. Это то, как разработка может наимпактить на бизнес-метрики: дать продактам большую платформу для обкатки гипотез, чтобы вычленять из них самые успешные.
Важно, что изначальная хотелка в нашем примере, да и в жизни, может звучать как «побыстрее». Но на самом деле под ней скрывается потребность в оптимизации не latency, а пропускной способности нашей системы! В другой ситуации то же самое «побыстрее» вполне может означать, что надо уметь делать топ-приоритетные проекты с наименьшим TTM, а не катить как можно больше за период.
Накидываем гипотезы по обратной индукции. Берём шкалу «усилия — результат» и по той же обратной индукции накидываем на неё гипотезы, которые хочется проверить.
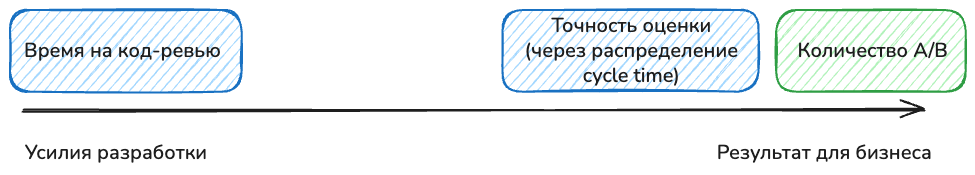
Допустим, мы слышим жалобы, что планы на сезон рвутся из-за неточной оценки, и лучше бы тогда взяли других фич попроще. Проверим эту гипотезу, посмотрев на распределение cycle time в командах. Берём cycle time, потому что время ожидания в бэклоге нас не интересует, — хотим проверить именно саму фазу разработки.
И ещё хотим по собственным наблюдениям за разработкой проверить гипотезу о времени на код-ревью. Мы видели несколько затянутых обсуждений в PR и хотим понять, могут ли они системно влиять на точность оценки.
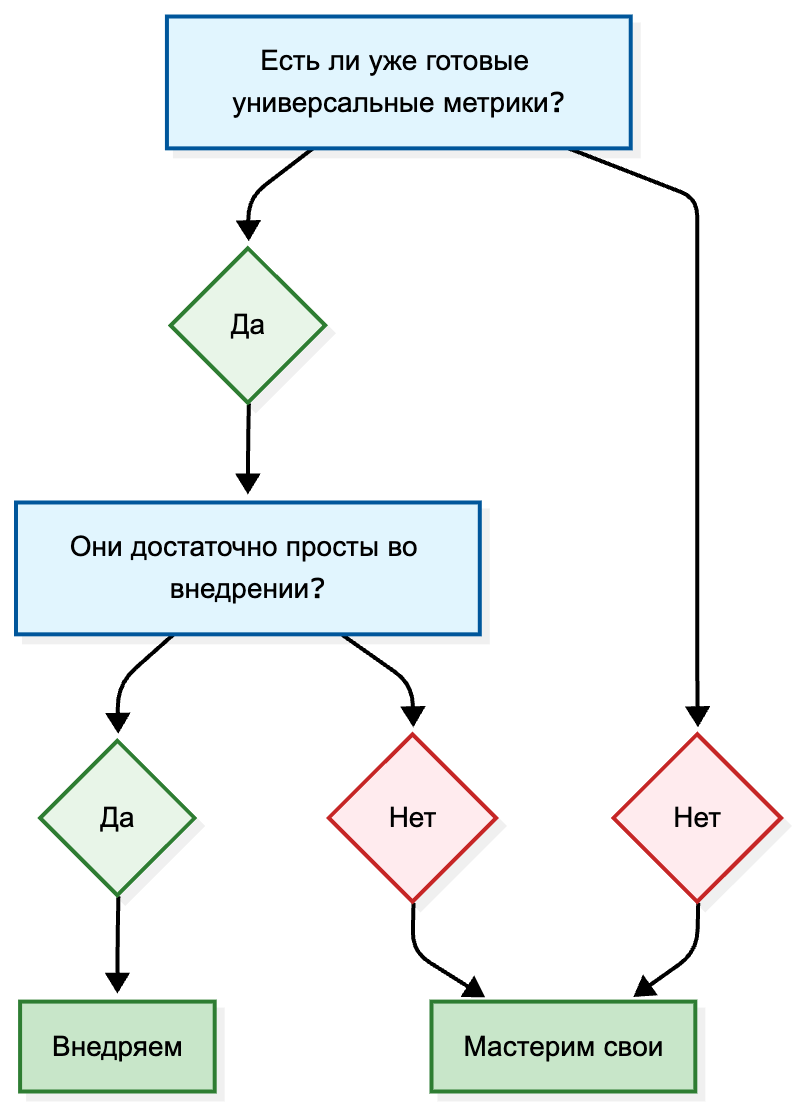
Мастерим метрики. Для этих гипотез проверяем, есть ли уже придуманные человечеством универсальные метрики. Если нет или они слишком сложны во внедрении — мастерим свои.
Дополняем. Если считаем, что какие-то области в цепочке не покрыты, а было бы неплохо (ну, вот просто хочется), — накидываем туда самые простые универсальные метрики, какие найдём. В нашем случае хочется проверить частоту деплоев просто потому, что данные для этой метрики уже доступны в компании, и это поможет нам закрыть целую фазу SDLC.
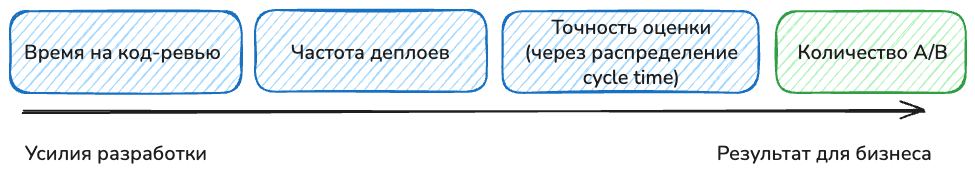
Это, естественно, примеры — у вас свои цели и гипотезы. Поздравляю, вы собрали свой фреймворк для оцифровки!
Развиваем. Дальше вы постепенно его наращиваете:
- уточняем гипотезы, анализируя результаты;
- добавляем метрики для новых гипотез и непокрытых фаз цикла разработки;
- удаляем метрики для неактуальных гипотез.
А если гипотеза не подтвердилась и метрика не прижилась — удаляйте её! Постепенно автоматизируйте сбор оставшихся метрик и заходите в направления с меньшими приоритетами, например, в надёжность.
Моделирование и backtesting. Когда строите метрики, проводите backtesting и моделируйте метрики в Excel до того, как начнёте внедрять в живую систему. Для сложных метрик внедрение может быть дорогостоящим, а простая выгрузка исторических данных в эксель может показать, что метрика несостоятельна.
Итого:
- Формулируем целевую метрику.
- По обратной индукции отстраиваем гипотезы.
- Выбираем для гипотез самые важные + самые простые метрики.
- Дополняем по желанию и новым потребностям.
- Не забываем делать моделирование и backtesting.
Заключение
Первая половина 2020-х годов в IT-индустрии прошла под трендом повышения эффективности разработки. Придумано множество фреймворков, написаны статьи, сделаны доклады. Обусловлено это экономическими сдвигами, и я думаю, что целевая аудитория статьи сталкивалась с их последствиями: сокращения, кропотливый подсчёт хедкаунта, закрытие найма. Надо делать столько же (или больше) меньшими силами. Чтобы так делать, надо оптимизировать процессы. Чтобы оптимизировать процессы, надо замерять результаты.
Это понятная цепочка умозаключений, моя же цель — настроить замеры и оптимизацию на правильный лад: разделять средства и цели; примерять цели бизнеса на разработку и оцифровывать их; проводить комплексные оптимизации, а не искать локальные оптимумы в отдельных этапах SDLC; масштабировать фреймворк оцифровки на отдельные команды и выражать с его помощью цели для сотрудников. Так, долгой и упорной работой можно достичь действительного роста производительности труда.
Вторая половина 2020-х — это эпоха AI 4 SDLC, то есть всё тот же рост производительности труда, но уже техническими средствами. Чтобы прирост продуктивности не ушёл в пустоту, а прокрасился в конечный результат деятельности разработки, опять же необходимо понимать цели и иметь систему метрик от целевых для отладочных. Тогда влияние ИИ на эффективность разработки будет доказанным и измеренным. Иначе опять откатимся на десятилетия и будем считать строки кода (но теперь написанные ИИ-агентом, а не программистом).
Благодарности
На моё мировоззрение повлияли:
- Щедровицкий Георгий. «Оргуправленческое мышление»
- Моженков Владимир. «Ген директора»
- Beck Kent. «Measuring Developer Productivity? A Response to McKinsey.»
Отдельная благодарность Александру Коныгину, Тимофею Таленфельду и Павлу Савченкову, которые внесли неоценимый вклад в оцифровку рабочих процессов, когда мы с ними трудили в Яндекс Вертикалях.